NUC AI 實驗室 · 地端服務管理
當地端模型的設備增多,你需要一個 Dashboard 管理你的 Local LLM API Key
從一台到多台,模型入口和 API Key 越來越多。我做了一個 Dashboard,把它們整理在一起,也順手看見每個服務現在的狀態。
機器變多,記住入口反而變成負擔
我陸續把 GX10、ROG NUC 等設備架成地端模型的算力提供者。平常使用模型的電腦,不一定是實際執行推論的那一台。模型各自跑得起來之後,URL、API Key,以及不同設備現在的狀態,開始變得不好管理。
最困擾我的時候,是 client 突然連不上。是這台電腦的設定不對?模型服務停了?還是提供算力的設備根本已經離線?如果每次都從頭找入口、換設備確認,原本想做的事情就被打斷了。
所以我想先回答一個很日常的問題:現在有哪些服務可用;不能用的話,我該從哪裡開始查?
把服務入口和狀態放在一起
我寫了一個 Dashboard,集中整理這些採用 OpenAI 相容 API 介面的模型服務。入口資訊與存取所需的 Key 放在同一處管理,旁邊直接呈現模型和服務狀態,減少在不同設定畫面之間找資料。
每 60 秒輪詢一次,讓狀態自己更新。這是近即時的觀察:畫面代表最近一次偵測,不是此刻毫無延遲的保證。當我看到異常,仍會先看更新時間,再決定下一步。
我關心的不只有綠燈或紅燈。服務在線、模型已經載入,以及請求能順利完成,是不同的事情;面板應該幫我看出差別,而不是把它們都簡化成「正常」。
現在的畫面,能告訴我什麼?
總覽區把運作中、待命與離線分開。模型卡片則呈現模型名稱、Context,以及服務能提供的負載資訊。這次畫面可看到處理中數量與 KV cache;沒有資料的欄位顯示空值,不把缺資料當成零。
我也想藉此掌握排隊狀況,但「處理中數量」不等於完整的等待佇列。不同 runtime 提供的欄位可能不同,解讀前要先知道每個數字代表什麼。
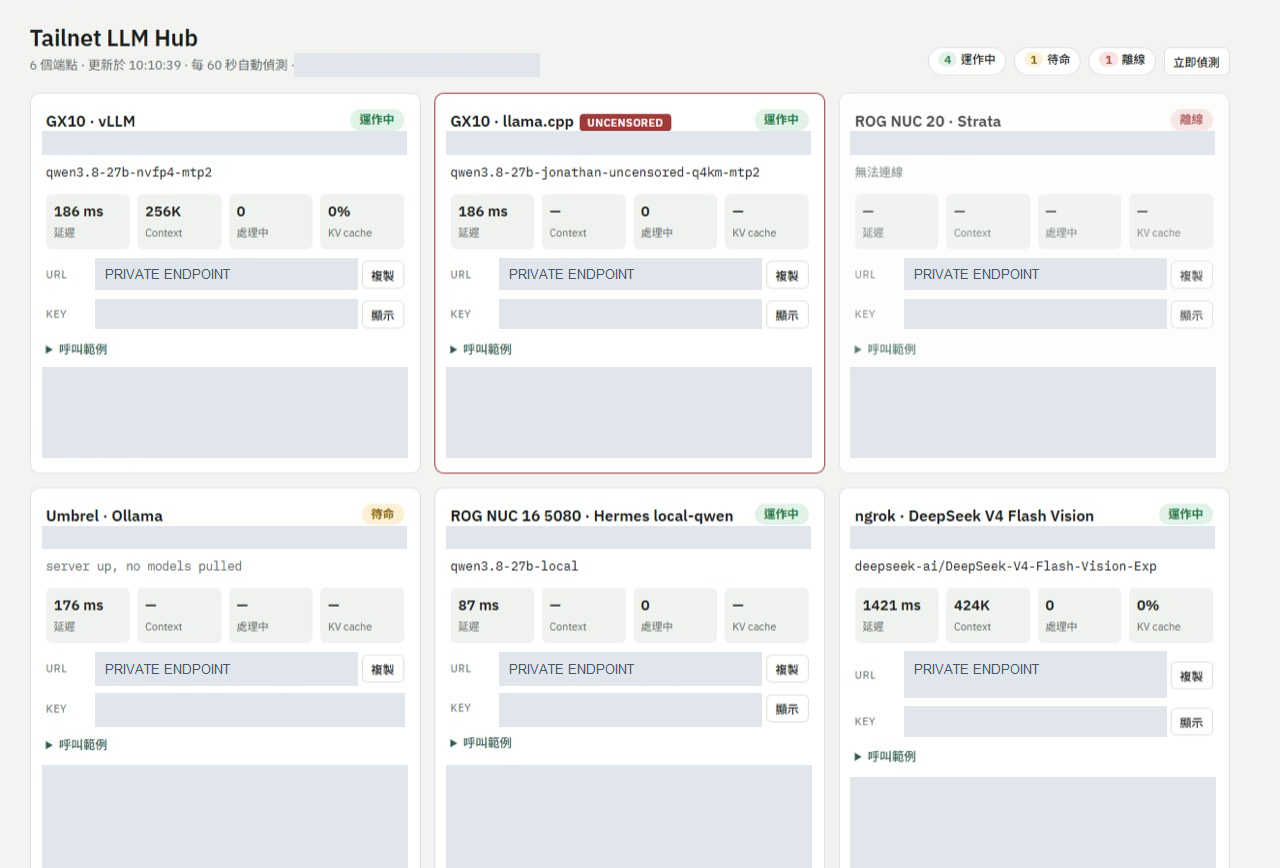
點圖可放大查看。保留原介面的中文欄位;數值是當下快照,不是效能測試結果。
連不上時,先把問題拆開
我把 SSH 連線狀態也放進 Dashboard。跨設備排查時,我不只想知道模型有沒有回應,也想知道管理連線是否可用,以及驗證是否通過。SSH 可連,不代表模型 API 正常;反過來,模型能回覆,也不代表 SSH 一定已設定好。
遇到問題時,我會先看最近的狀態,再往下看偵測紀錄,縮小需要檢查的範圍。這些是排查線索,不是自動判定根因的結論。
- 先看更新時間:如果資料已經過期,先確認監測本身是否還有運作。
- 再看模型服務:確認是離線、待命,還是已有負載,並核對 client 指向的入口。
- 接著看 SSH 狀態:把設備連線、管理權限與模型服務的問題分開。
- 最後對照偵測紀錄:針對可疑的那一層排查,不一開始就重設所有設定。
讓手機也看得到,但不把管理面板當公開網站
我把 web server 放在一台預計 24 小時開機的設備上。日常電腦或手機加入獲准的 Tailscale 網路後,就能透過它提供的網域名稱打開面板,不必每次坐到提供算力的機器前面。
Tailscale 讓我可以走私有網路存取,降低為了遠端使用而直接開放服務到公網的需求。網域名稱方便記憶,但存取仍取決於網路連線與權限;它不是「有連結就能看」的公開頁面。
這裡也有一個要分清楚的邊界:Dashboard 的存取範圍,不等於所有被列入的模型端點的存取範圍。每個服務有沒有其他對外入口、誰可以使用,都要分別確認。
做出面板之後,還有哪些事沒解決?
目前的價值,是把原本分散的資訊放回同一個排查起點。我還沒有做前後對照量測,因此不會說它已經縮短多少百分比的維護時間,也不把畫面上的延遲當成模型生成速度。
每分鐘輪詢可能漏掉兩次偵測之間的短暫異常;Context 欄位也不等於我已驗證每個長度都能穩定推論。設備保持開機是一個部署安排,還不是高可用性的承諾。
把 API Key 整理在面板裡,也不表示我已經完成一套正式的秘密管理系統。憑證的保存、顯示權限與輪替方式,仍需要獨立檢查;分享畫面時更不能把這些識別資訊一起帶出去。
下一步,我想知道它能不能真的幫上忙
接下來我想記錄幾次真實的連線異常:從發現問題,到找到出錯環節,各花了多久,哪些欄位真的有幫助。如果只有數字變多,卻沒有讓判斷更容易,那就該調整面板,而不是再加一排圖表。
更清楚的資料過期提示、異常通知,以及各種 runtime 的欄位定義,也都是想繼續補的方向。這些目前是下一步,還不是已完成的功能。
對我來說,這是地端 AI 走進日常工作的一小步:除了讓模型跑起來,也要讓使用它的人知道出了問題時該怎麼辦。